KI & Hardware 14.10.2025 5 Min. Lesezeitapertus.ai Team
DGX Spark im Test: Benchmarks & Alternativen
Update Oktober 2026: Die KI-Kiste basiert inzwischen selbst auf dem NVIDIA GB10, dem Chip im DGX Spark. Mit Mixture-of-Experts-Modellen wie Gemma 4 26B-A4B schafft er heute rund 100 Token pro Sekunde, aktuelle Richtwerte findet ihr in unseren Benchmarks. Für viele parallele Nutzer gibt es das KI-Kraftwerk mit bis zu vier RTX PRO 6000.
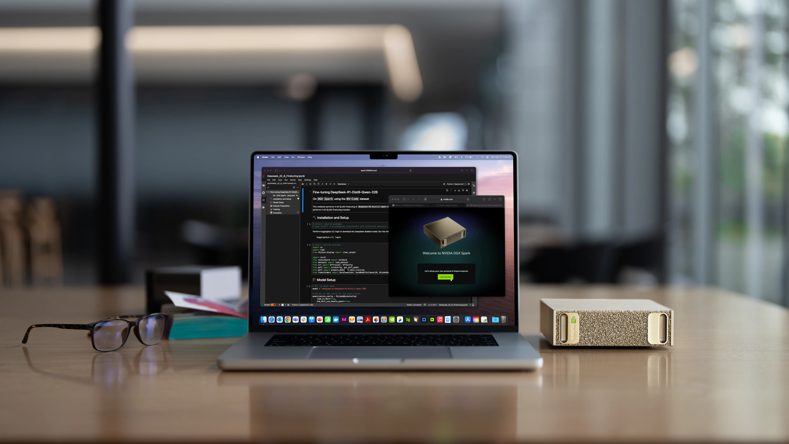
NVIDIA hat den DGX Spark mit einem Hauch von Gold und dem Marketing-Slogan “Supercomputer für den Schreibtisch” vorgestellt. Wir haben uns die Reviews der Community angeschaut und zusammengefasst.
Die Idee ist revolutionär: Entwickler sollen die gleiche Architektur wie in den riesigen DGX-Rechenzentren direkt auf ihren Schreibtisch bekommen. Mit 128 GB Unified Memory und einem leistungsstarken GB10-Chip schien dies das Ende der Speichergrenzen für lokale Large Language Models (LLMs) zu sein.
Doch wie erste detaillierte Benchmarks und die kritische Reaktion der Community zeigen, hat die goldene Fassade einen entscheidenden Haken. Wir beleuchten die Architektur, analysieren die Performance und stellen fest: Für wen ist dieser “Supercomputer” wirklich gebaut?
Der Flaschenhals ist nicht der Compute-Kern, sondern die Datenautobahn. Der DGX Spark leidet unter einer im Vergleich zur GPU-Leistung zu geringen Speicherbandbreite, was die Geschwindigkeit der Token-Generierung (Decode-Performance) bei großen Modellen stark limitiert.
Die Architektur-Falle: Compute vs. Bandbreite
Der DGX Spark basiert auf dem Blackwell-Chip GB10. Er liefert beeindruckende bis zu 1 Petaflop (Sparse FP4) Compute-Leistung. Das zentrale Verkaufsargument ist der 128 GB kohärente LPDDR5X Unified Memory, der es ermöglicht, selbst riesige Modelle (wie z.B. Llama 3.1 70B) vollständig in den Speicher zu laden.
Der Sweet Spot und der harte Stopp
Die Benchmarks bestätigen, dass der Spark exzellent im Prefill (dem Laden von Daten und der Verarbeitung des initialen Prompts) und im Umgang mit kleinen bis mittelgroßen Modellen (bis 20B) ist. Auch die Skalierungseffizienz über Batches hinweg ist dank Software-Optimierungen wie dem spekulativen Decodieren sehr gut.
- Prefill-Leistung: Beeindruckend, dank starkem Compute.
- Speichergröße: 128 GB Unified Memory eliminiert das VRAM-Limit für fast alle Open-Source-LLMs.
Der harte Stopp erfolgt jedoch bei der Token-Generierung (Decode-Performance) für Modelle ab 70B. Hier kommt die limitierte Bandbreite von 273 GB/s ins Spiel – ein Wert, der für die Bewegung der gigantischen Modellgewichte während der fortlaufenden Inferenz einfach nicht ausreicht. Die Community vergleicht diese Geschwindigkeit zynisch mit der P40-Ära älterer Rechenzentrumskarten.
Dies ist ein Beispiel: Die Llama 3.1 70B generiert auf dem Spark mit ca. 2.7 Tokens pro Sekunde (tps), während eine gut optimierte RTX 6000 (mit höherer Bandbreite) auf einem 120B-Modell über 240 tps erreichen kann.
Der Unterschied zwischen Prefill und Decode: Die Prefill-Leistung ist wichtig, wenn Sie sehr lange Prompts verarbeiten. Die Decode-Leistung (Tokens/Sekunde) ist entscheidend dafür, wie schnell Sie eine Antwort vom Modell erhalten – der wichtigste Wert für die Chat-Interaktion.
Der direkte Showdown: Spark vs. Alternativen
Die Community des lokalen KI-Ökosystems ist sich einig: Gemessen am Preis-Leistungs-Verhältnis für die reine Inferenzleistung liegt der DGX Spark weit hinter den etablierten Alternativen.
Warum Multi-GPU-Setups gewinnen
Nutzer mit einem begrenzten Budget können für denselben Preis, den NVIDIA für den DGX Spark verlangt, ein Multi-GPU-Setup mit drei bis vier RTX 3090-Karten (insgesamt 72-96 GB VRAM) oder einer RTX 5090-Karte (32GB GDDR7) kaufen.
- Leistungsvorteil: Diese Setups erzielen auf Modellen wie GPT-OSS 120B eine Decode-Leistung von 90 bis 120 tps – fast das Zehnfache der Spark-Performance.
- Flexibilität: Die Konkurrenz-Setups laufen auf Standard-x86-64-Plattformen und bieten volle Kompatibilität für Gaming, andere Produktivitäts-Apps und das breitere CUDA-Ökosystem.
Für Unternehmen mit vielen parallelen Nutzern gibt es dieses Prinzip als KI-Kraftwerk: 1 bis 4× NVIDIA RTX PRO 6000 Blackwell, von uns vor Ort installiert und gewartet.
Vor dem Hardwarekauf die Performance testen: Viele Open-Source-Modelle, die lokal laufen, bieten wir auch als Cloud-Modelle über unser Gateway an. So bekommt ihr vorab einen Eindruck, wie sich Tempo und Qualität anfühlen. Über die Unterschiede zwischen lokaler und Cloud Inference für KMUs haben wir schon hier geschrieben.
Apple M-Chips als heimlicher Sieger
Der wohl schärfste Konkurrent in der Desktop-KI ist Apple Silicon.
- Überlegene Bandbreite: M-Chips verfügen über eine deutlich höhere Speicherbandbreite als die 273 GB/s des Spark, was sich direkt in der Token-Generierung auszahlt. Ein Mac Studio M4 Max liefert auf dem GPT-OSS 120B-Modell (je nach Quelle) bereits ca. 60 tps.
- Effizienz: Apple bietet dies in einer extrem energieeffizienten und leisen Umgebung. Das Urteil ist klar: Das “Supercomputer”-Marketing des Spark ist zu spät, da Apple bei der Desktop-KI in Bezug auf Inferenz-Speed bereits die Führung übernommen hat.
Vergleich (GPT-OSS 120B):
1. Multi-GPU-Setup RTX 3090 → ~100 tps
2. Mac Studio M4 Max → ~60 tps
3. NVIDIA DGX Spark → ~11.66 tps
Die Leistung des Sparks für GPT-OSS 120B liegt bei 11.66 tps bei Batch 1. Dies zeigt, dass die Optimierung für FP4/Sparse Compute die fundamentale Bandbreitenbeschränkung nicht überwinden kann.
Conclusion: Der DGX Spark ist ein Entwickler-Kit
Der DGX Spark ist, wie einige Kommentatoren treffend feststellten, in erster Linie ein Entwickler-Kit. Er wurde nicht gebaut, um mit einer RTX 5090 oder einem Multi-GPU-Setup zu konkurrieren. Sein Zweck ist es, die Rechenzentrumsarchitektur und den Software-Stack von NVIDIA (SGLang, DGX OS) im Mini-Format zu replizieren.
Für Unternehmen, die ihre lokal entwickelten KI-Modelle nahtlos und verlustfrei auf die großen NVIDIA-DGX-Server im Rechenzentrum skalieren wollen, ist er der perfekte goldene Schlüssel. Für jeden, der maximale Inferenzleistung pro Euro für lokale LLM-Anwendungen sucht, ist er jedoch überteuert und zu langsam.
Unser Tipp: Bevor Sie in High-End-KI-Hardware investieren, analysieren Sie Ihren primären Anwendungsfall: Benötigen Sie Hardware um Ihren Software-Stack für spätere Nutzung im Rechenzentrum zu testen oder um effizient KI-Modelle lokal und sicher zu betreiben? Die Antwort entscheidet, ob Sie auf Effizienz (Multi-GPU wie das KI-Kraftwerk, Apple) oder auf Ökosystem (DGX Spark) setzen sollten. Mit aktuellen Mixture-of-Experts-Modellen ist der GB10 inzwischen auch für die Inferenz schnell genug, deshalb basiert die KI-Kiste heute darauf.
Quellen
NVIDIA DGX Press Release: NVIDIA DGX Spark Arrives for World’s AI Developers, NVIDIA 2025
NVIDIA DGX Spark In-Depth Review: Das Originalvideo von LMSYS Org Official, LMSYS Org 2025
DGX Spark Reddit-Diskussion: DGX Spark review with benchmark : r/LocalLLaMA, Reddit
NNVIDIA DGX Spark In-Depth Review: In-Depth Benchmarking and Test, Jerry Zhou and Richard Chen 2025